
UNIQUE制約を付けたはずなのにNULLのレコードが何件も登録できてしまうことってありますよね。
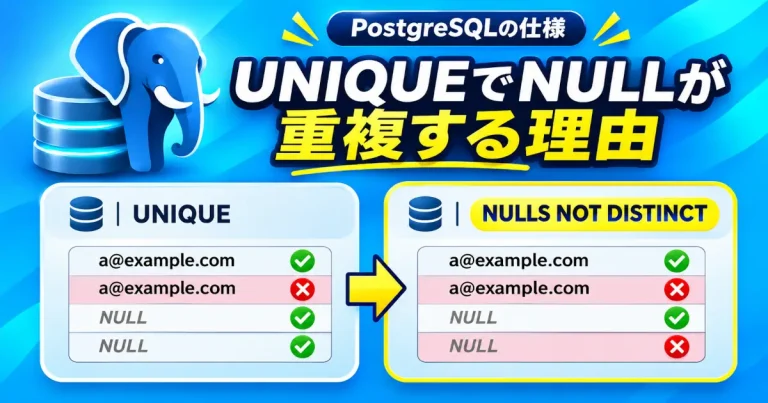
結論から言うと、PostgreSQLのUNIQUE制約は既定でNULL同士を「同じ値」として扱いません。そのためNULLは何件入れても重複エラーになりません。PostgreSQL 15以降ならNULLS NOT DISTINCTを指定することで、NULL同士も重複として扱えるようになります。
この記事では、Ubuntu 24.04上のPostgreSQL 16.15で実際にINSERTを実行しながら、成功するINSERTと失敗するINSERTを見比べます。単一列と複合UNIQUE制約での違い、すでにデータが入っているテーブルへの適用方法まで解説します。
NULLが複数入るのはPostgreSQLの仕様
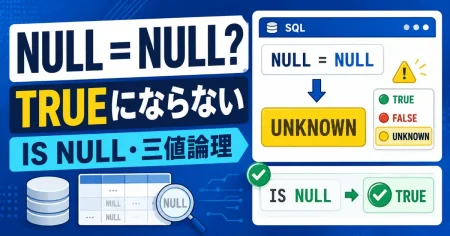
NULLは「値が不明」を表す特別な印でNULL = NULLの結果はTRUEではなくNULL(UNKNOWN)になります。UNIQUE制約の重複チェックでもNULL同士は等しいとは判定されません。
PostgreSQLの公式ドキュメント(Unique Indexes)にもユニークな列ではNULLを既定で等しいとみなさず、複数のNULLを許すと書かれています。不具合ではなく仕様です。
この既定の動きはNULLS DISTINCT(NULLを区別する)と呼ばれ、明示的に書くこともできます。NULLS NOT DISTINCTを指定したときだけNULLを等しい値として扱うようになります。
| 比べる点 | 既定(NULLS DISTINCT) | NULLS NOT DISTINCT |
|---|---|---|
| NULL同士の扱い | 重複とみなさない | 重複とみなす |
| NULLを2件INSERT | どちらも成功 | 2件目が失敗 |
| 使えるバージョン | 15より前も同じ挙動 | PostgreSQL 15以降 |
NULL = NULL がTRUEにならない理由やIS NULLで判定したときの違いはSQLの実行例で確認できます。
INSERTで既定の動きを確認する
まずは既定の動きを確認します。メールアドレスの列にUNIQUE制約を付けたテーブルを用意します。
テーブルを作る
CREATE TABLE users (
  id    serial PRIMARY KEY,
  email text UNIQUE
);
UNIQUE制約を付けるとPostgreSQLは裏でユニークなインデックスを自動で作り、重複チェックはそのインデックスで行います。NULLを等しく扱うかどうかもこのインデックスの設定です。
INSERTを実行する
同じメールアドレスを2回、NULLを3回入れてみます。
INSERT INTO users (email) VALUES ('a@example.com');
INSERT INTO users (email) VALUES ('a@example.com');
INSERT INTO users (email) VALUES (NULL);
INSERT INTO users (email) VALUES (NULL);
INSERT INTO users (email) VALUES (NULL);INSERT 0 1
ERROR: duplicate key value violates unique constraint "users_email_key"
DETAIL: Key (email)=(a@example.com) already exists.
INSERT 0 1
INSERT 0 1
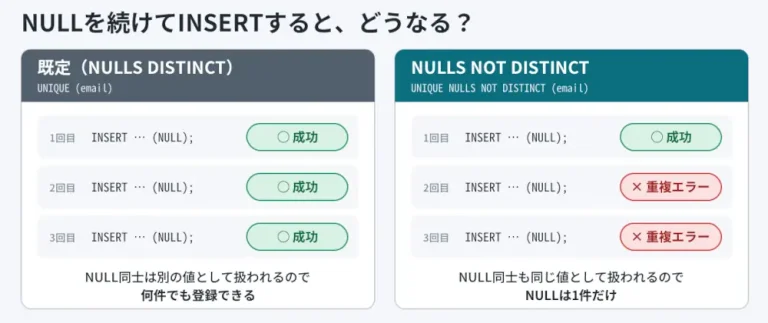
INSERT 0 1同じメールアドレスの2回目は重複エラーになりましたが、NULLは3回とも成功しています。
| INSERT | 結果 |
|---|---|
| ‘a@example.com‘(1回目) | 成功 |
| ‘a@example.com‘(2回目) | 重複エラー |
| NULL(1回目から3回目) | すべて成功 |
テーブルの中身も見てみます。
SELECT * FROM users ORDER BY id;id | email
----+---------------
1 | a@example.com
3 |
4 |
5 |
(4 rows)NULLの行が3件並んでいます。UNIQUE制約があってもNULLだけは重複として弾かれないわけですね。
NULLS NOT DISTINCTでNULL同士も重複扱いにする
NULLも重複として弾きたいときはUNIQUE制約にNULLS NOT DISTINCTを付けます。この指定はPostgreSQL 15で追加されました。
列制約として指定する
CREATE TABLE users_nnd (
  id    serial PRIMARY KEY,
  email text UNIQUE NULLS NOT DISTINCT
);INSERT INTO users_nnd (email) VALUES ('a@example.com');
INSERT INTO users_nnd (email) VALUES (NULL);
INSERT INTO users_nnd (email) VALUES (NULL);INSERT 0 1
INSERT 0 1
ERROR: duplicate key value violates unique constraint "users_nnd_email_key"
DETAIL: Key (email)=(null) already exists.1回目のNULLは通りますが2回目で重複エラーになりました。DETAILの部分にはNULLが(null)と表示されます。
設定できているかはpsqlの\dでも確認できます。
\d users_nndIndexes:
"users_nnd_pkey" PRIMARY KEY, btree (id)
"users_nnd_email_key" UNIQUE CONSTRAINT, btree (email) NULLS NOT DISTINCT書く位置に注意
NULLS NOT DISTINCTは書く位置が決まっています。UNIQUE制約ではUNIQUEの直後に書く必要があり、列名のカッコの後ろに付けると構文エラーになります。
CREATE TABLE wrong_order (id serial PRIMARY KEY, email text, UNIQUE (email) NULLS NOT DISTINCT);ERROR: syntax error at or near "NULLS"書き方は次の3パターンです。CREATE UNIQUE INDEXだけは逆に列のカッコの後ろに付けます。
| 書き方 | 記述の例 |
|---|---|
| 列制約 | email text UNIQUE NULLS NOT DISTINCT |
| テーブル制約 | UNIQUE NULLS NOT DISTINCT (【列名】) |
| CREATE UNIQUE INDEX | CREATE UNIQUE INDEX 【インデックス名】 ON 【テーブル名】 (【列名】) NULLS NOT DISTINCT; |
\dではインデックスにNULLS NOT DISTINCTと表示されます。
複合UNIQUE制約でのNULLの扱い
複数の列を組み合わせたUNIQUE制約では、少しわかりにくい動きになります。
公式ドキュメントによると、複数列のユニークインデックスは「すべての列が等しい行」が複数あるときだけ拒否します。既定ではNULLは等しくないので組み合わせのうち1列でもNULLなら重複扱いにならないはずです。実際に確かめます。
CREATE TABLE subs (
  id        serial PRIMARY KEY,
  user_id   int,
  plan_code text,
  UNIQUE (user_id, plan_code)
);CREATE TABLE subs_nnd (
id serial PRIMARY KEY,
user_id int,
plan_code text,
UNIQUE NULLS NOT DISTINCT (user_id, plan_code)
);どちらのテーブルにも、同じ組み合わせを2回ずつINSERTしました。2回目の結果をまとめます。
| 2回目にINSERTした組み合わせ(user_id, plan_code) | 既定 | NULLS NOT DISTINCT |
|---|---|---|
| (1, ‘basic’) | 重複エラー | 重複エラー |
| (1, NULL) | 成功 | 重複エラー |
| (NULL, ‘basic’) | 成功 | 重複エラー |
| (NULL, NULL) | 成功 | 重複エラー |
既定のテーブルではNULLを含む組み合わせはどれだけ同じ値を入れても通ります。たとえばuser_idと plan_codeの組み合わせを一意にしたくてもplan_codeがNULLの行は何件でも入ってしまうわけです。
NULLS NOT DISTINCTを付けたテーブルではNULLを含む組み合わせも重複として弾かれました。エラーのDETAILにはNULLを含んだまま組み合わせが表示されます。
ERROR:  duplicate key value violates unique constraint "subs_nnd_user_id_plan_code_key"
DETAIL: Key (user_id, plan_code)=(1, null) already exists.なお(2, NULL)のように別の組み合わせならNULLS NOT DISTINCTでも問題なく入ります。
既存テーブルのUNIQUE制約をNULLS NOT DISTINCTに変更する
すでに運用中のテーブルはUNIQUE制約を作り直す形でNULLS NOT DISTINCTに変更します。実行時点でテーブルにNULLの重複がすでに入っていると変更できないので、順番に進めます。
ここでは、次のデータが入ったmembersテーブルで試します。
CREATE TABLE members (
  id    serial PRIMARY KEY,
  email text,
  CONSTRAINT members_email_key UNIQUE (email)
);

INSERT INTO members (email)
VALUES ('a@example.com'), ('b@example.com'), (NULL), (NULL), (NULL);
NULLの重複がないか確認する
重複の確認にはGROUP BYとarray_aggが便利です。GROUP BYはNULLを1つのグループにまとめるのでNULLの重複も拾えます。
SELECT email, count(*) AS cnt, array_agg(id ORDER BY id) AS ids
FROM members
GROUP BY email
HAVING count(*) > 1;email | cnt | ids
-------+-----+---------
| 3 | {3,4,5}
(1 row)emailがNULLの行は3件あり、IDは3、4、5です。今回はNULLの重複を調べたいので WHERE email IS NOT NULLは付けていません。
NULLを除外する条件や複数列の組み合わせで重複するIDを調べる方法は次の記事で確認できます。

重複が存在したままユニーク制約を変更するとどうなるか
重複を残したままUNIQUE制約を付け替えるとエラーになります。
ALTER TABLE members
  DROP CONSTRAINT members_email_key,
ADD CONSTRAINT members_email_key UNIQUE NULLS NOT DISTINCT (email);ERROR: could not create unique index "members_email_key"
DETAIL: Key (email)=(null) is duplicated.失敗したあとに\d membersで確認すると元のUNIQUE制約はそのまま残っていました。制約が外れた状態で放置される心配はありません。
重複しているNULLを整理する
付け替えるには、NULLを1件だけにする必要があります。ここでは例として最小のidだけを残して残りを削除します。
BEGIN;

DELETE FROM members
WHERE email IS NULL
AND id <> (SELECT min(id) FROM members WHERE email IS NULL);

SELECT * FROM members ORDER BY id;
ここで実行を止めて残った行を確認します。削除を確定する場合は同じ接続で続けて次のSQLを実行してください。
COMMIT;逆に確定させず変更(削除)を取り消す場合はCOMMITの代わりに次を実行します。
COMMIROLLBACK;この例では検証用データのNULLを1件に整理しています。実際のデータで同じ操作をするときは削除対象の行を確認し、確定するか取り消すかを判断してください。
UNIQUE制約を付け替える
NULLが1件になったので、もう一度付け替えます。
ALTER TABLE members
  DROP CONSTRAINT members_email_key,
ADD CONSTRAINT members_email_key UNIQUE NULLS NOT DISTINCT (email);ALTER TABLE続けて\d membersで確認すると制約にNULLS NOT DISTINCTが付いています。
Indexes:
    "members_pkey" PRIMARY KEY, btree (id)
    "members_email_key" UNIQUE CONSTRAINT, btree (email) NULLS NOT DISTINCT
これでNULLを追加しようとすると重複エラーになります。
INSERT INTO members (email) VALUES (NULL);ERROR: duplicate key value violates unique constraint "members_email_key"
DETAIL: Key (email)=(null) already exists.更新をブロックする時間を短くしたい場合
ALTER TABLE ... ADD CONSTRAINTでUNIQUE制約を作るとその場でインデックスも作るため、データが多いテーブルでは更新をブロックする時間が長くなることがあります。公式ドキュメントでも更新をあまり止めずに制約を追加したいときは、先にCREATE UNIQUE INDEX CONCURRENTLYでインデックスを作り、あとから制約に変換する方法が紹介されています。
NULLS NOT DISTINCTでも同じ手順で動きました。membersと同じ構成でNULLの重複がないmembers2という別のテーブルで試した例です。
CREATE UNIQUE INDEX CONCURRENTLY members2_email_nnd_idx
ON members2 (email) NULLS NOT DISTINCT;ALTER TABLE members2
DROP CONSTRAINT members2_email_key,
ADD CONSTRAINT members2_email_key UNIQUE USING INDEX members2_email_nnd_idx;変換後の\d members2では制約にNULLS NOT DISTINCTがそのまま引き継がれていました。
Indexes:
    "members2_pkey" PRIMARY KEY, btree (id)
    "members2_email_key" UNIQUE CONSTRAINT, btree (email) NULLS NOT DISTINCT
この方法には注意点が2つあります。
CREATE INDEX CONCURRENTLYはトランザクションブロックの中では実行できません。- NULLの重複が残ったまま実行すると失敗し
INVALID(無効)なインデックスが残ります。
同じmembers2にNULLが2件入っている整理前の状態でCREATE UNIQUE INDEX CONCURRENTLYを実行すると次のようになりました。
ERROR:  could not create unique index "members2_email_nnd_idx"
DETAIL:  Key (email)=(null) is duplicated.

Indexes:
    "members2_pkey" PRIMARY KEY, btree (id)
    "members2_email_key" UNIQUE CONSTRAINT, btree (email)
"members2_email_nnd_idx" UNIQUE, btree (email) NULLS NOT DISTINCT INVALIDINVALIDのインデックスは検索には使われませんが更新時の負荷が残ります。ユニークインデックスの並行作成では、失敗した段階によって一意性のチェックも続く場合があります。公式ドキュメントでは失敗して残ったインデックスを削除してから作成し直す方法が案内されています。
DROP INDEX members2_email_nnd_idx;NULLの重複を整理したあとでもう一度CREATE UNIQUE INDEX CONCURRENTLYから実行すれば、先ほどの手順どおりに制約へ変換できます。
NULLS NOT DISTINCT・NOT NULL・何もしないの使い分け
UNIQUE NULLS NOT DISTINCTは重複チェックでNULL同士を同じものとして扱います。単一列ならNULLは1件まで、複合列ならNULLを含む同じ組み合わせは1件まで登録できます。NULLそのものを禁止したい場合はNOT NULLを使います。
| やりたいこと | 選ぶ設定 |
|---|---|
| 値の重複を防ぎ、NULLは複数許可したい | 通常のUNIQUE制約 |
| NULLも含めて同じ値・同じ組み合わせの重複を防ぎたい | UNIQUE NULLS NOT DISTINCT |
| NULLそのものを禁止したい | NOT NULL制約 |
| NULLを禁止し、値の重複も防ぎたい | NOT NULL制約とUNIQUE制約 |
「NULLが複数入って困る」場合でも本当に困っているのがNULLの重複なのか、そもそもNULLが入ること自体なのかで選ぶ設定が変わります。
迷いやすいポイント
空文字(”)とNULLは同じ扱いになる?
別物です。空文字は値として扱われるので既定のUNIQUE制約でも2回目は重複エラーになります。
INSERT INTO users (email) VALUES ('');
INSERT INTO users (email) VALUES ('');INSERT 0 1
ERROR: duplicate key value violates unique constraint "users_email_key"
DETAIL: Key (email)=() already exists.NULLは何件でも入るのに空文字は1件までという違いが出ます。空文字も文字列なので、当然問ば当然ですね。
ON CONFLICT DO NOTHINGではNULLはどうなる?
既定のUNIQUE制約ではNULLが衝突しないのでON CONFLICT DO NOTHINGを付けていても毎回INSERTされます。NULLS NOT DISTINCTを付けたテーブルでは衝突として扱われINSERTがスキップされます。
INSERT INTO users (email) VALUES (NULL) ON CONFLICT (email) DO NOTHING;
INSERT INTO users_nnd (email) VALUES (NULL) ON CONFLICT (email) DO NOTHING;INSERT 0 1
INSERT 0 01行目は既定のusersテーブルでINSERTされ、2行目はNULLS NOT DISTINCTのusers_nnd テーブルで0件になりました。
PostgreSQL 14以前ではどうする?
NULLS NOT DISTINCTはPostgreSQL 15で追加された機能なので14以前では使えません。代わりにNULLの行だけを対象にした部分インデックスで「NULLは1件まで」を再現できます。
次の例はemail列を持つusers_oldテーブルに通常のUNIQUE制約が設定されていることを前提にしています。通常のUNIQUE制約でNULL以外の重複を防ぎ、追加する部分インデックスでNULLを1件までに制限します。既存データにNULLが複数ある場合は先に整理してください。
CREATE UNIQUE INDEX users_old_email_null_once
  ON users_old ((email IS NULL))
WHERE email IS NULL;NULLの行だけが対象になり、その行全てでemail IS NULLの値がtrueになるため、2件目のNULLは重複エラーになります。
ERROR:  duplicate key value violates unique constraint "users_old_email_null_once"
DETAIL:  Key ((email IS NULL))=(t) already exists.
これは単一列の場合の考え方です。
MySQLやSQL ServerなどほかのDBでも同じ?
DBによって扱いが違うことがあるのでPostgreSQL以外では各DBの公式ドキュメントで確認してください。NULLの比較の基本は共通でも、UNIQUE制約でのNULLの扱いは実装ごとに差があります。最初に紹介した記事の「よくある疑問」でも触れています。
まとめ
- PostgreSQLのUNIQUE制約は既定でNULL同士を重複とみなさないからNULLは何件でも入るよ。
NULLS NOT DISTINCTを付けるとNULL同士も重複として扱えるよ(PostgreSQL 15以降)。- 複合UNIQUE制約では既定だと1列でもNULLがあれば重複扱いにならないよ。
- 既存テーブルに付けるときは先にNULLの重複がないか確認してね。
- UNIQUE制約では
UNIQUE NULLS NOT DISTINCT (列名)の順に書くよ。UNIQUE (列名) NULLS NOT DISTINCTは構文エラーになるよ。