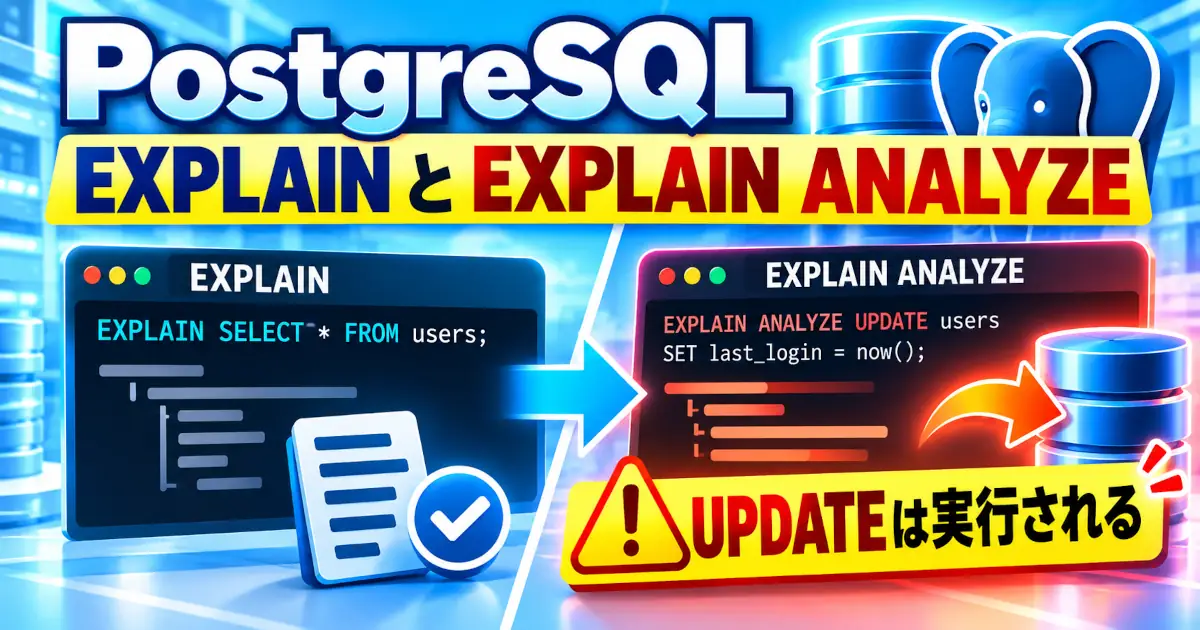
EXPLAINはSQLを実行せずに実行計画を表示し、EXPLAIN ANALYZEはSQLを実際に実行して行数や処理時間を測定します。UPDATE・DELETEにANALYZEを付けると更新・削除も実行されます。遅いSQLを調べる前にこの違いを確認しておきましょう。
この記事では実際にテーブルを作ってEXPLAINを動かしながら、両者の違いとUPDATE・DELETEに使うときの注意点をまとめます。検証にはPostgreSQL 16.15を使い20万件のダミーデータで実行計画がどう変わるかも確認しました。
- OS
Windows 11 Home 25H2
- PostgreSQL
16.15(Dockerコンテナ)
- Docker Desktop
4.92.0
手元でSQLを試す環境が必要な場合は、Docker ComposeでPostgreSQLを起動し接続するまでの手順を確認できます。
EXPLAINとEXPLAIN ANALYZEの比較表
| 項目 | EXPLAIN | EXPLAIN ANALYZE |
|---|---|---|
| SQLの実行 | しない(計画のみ表示) | する(実際に実行する) |
| 表示内容 | 見積もり(cost・rows・width) | 見積もりに加えて実測値(actual time・rows・loops) |
| SELECTへの適用 | 対象SQLを実行せず計画を確認する | 実際に実行する。負荷・ロック・関数の副作用に注意 |
| UPDATE・DELETEへの適用 | 更新・削除を実行せず計画を確認する | 更新・削除も実行する。変更を残さない場合はトランザクション内で確認する |
| 確認にかかる時間 | 計画の作成・表示にかかる時間 | SQLの実行に加え計測・表示にも時間がかかる |
| 主な用途 | 大まかな計画を素早く確認したいとき | 見積もりと実測のズレから性能問題を特定したいとき |
EXPLAINで分かること
まずはANALYZEを付けない状態から見ていきます。customer_id列にインデックスがないテーブルで、特定の顧客の注文を検索してみます。
EXPLAIN SELECT * FROM orders WHERE customer_id = 42;Seq Scan on orders (cost=0.00..3827.00 rows=20 width=22)
Filter: (customer_id = 42)出てくる数字はこの3つです。
- cost
プランナーが見積もったコスト。左の0.00が最初の1行を返すまでのコスト、右の3827.00が全行を返し終えるまでのコスト。
- rows
プランナーが見積もった、この処理で返ってくる行数。
- width
1行あたりの推定バイト数。
この時点ではSQLはまだ1回も実行されていません。プランナーが「たぶんこうなるだろう」と計算しただけの数字です。
costの数字はミリ秒ではない
ここは誤解しやすいポイントです。costの単位はミリ秒でも秒でもなくPostgreSQL内部の相対的な指標にすぎません。公式ドキュメントでもこの値は慣例的にディスクページの読み取り回数を基準にした任意の単位だと説明されています。なので「cost=3827だから3.8秒かかる」といった読み方はできません。あくまで「他のプランと比べてどちらが安そうか」を判断するための相対値だと考えておくのが安全です。
Seq ScanとIndex Scanの違い
上の例のSeq Scanはテーブルを順に読み、各行が条件に合うかを調べる方式です。少数の行だけを取り出したいのに大量の行を読む場合はインデックスで読み取りを減らせる可能性があります。
テーブルが小さい場合や多くの行を取得する場合はSeq Scanのほうが効率的なこともあります。インデックスがあっても必ず使われるわけではありません。後ほどcustomer_id列にインデックスを作成して今回の条件で実行計画がどう変わるかを確認します。
ANALYZEを付けると実際に実行される
公式ドキュメントではANALYZEオプションを使うとステートメントが実際に実行されると明記したうえで、SELECTが返すはずの出力は破棄されるものの、それ以外の副作用は通常どおり発生すると注意しています。
つまりEXPLAIN ANALYZEは「実行計画を見るためのおまけとしてついでに実行もされる」のではなく、「実際に実行した結果として実行計画と実測値を教えてくれる」コマンドだということです。
インデックスなしで実行してみる
先ほどと同じクエリにANALYZEを付けてみます。
EXPLAIN ANALYZE SELECT * FROM orders WHERE customer_id = 42;Seq Scan on orders (cost=0.00..3827.00 rows=20 width=22) (actual time=0.428..10.259 rows=19 loops=1)
Filter: (customer_id = 42)
Rows Removed by Filter: 199981
Planning Time: 0.211 ms
Execution Time: 10.292 ms見積もり(cost・rows・width)はさっきと同じですが、実測値が追加されています。
- actual time
実際にかかった時間(ミリ秒)。左が最初の1行が返るまで、右が全行を返し終えるまで。
- rows
実際に返った行数。今回は見積もり20に対して実測19と、ほぼ近い値でした。
- loops
このノードが実行された回数。ネストしたループの内側にあるノードだと2以上になることがあります。
- Rows Removed by Filter
フィルタ条件で除外された行数。今回は20万行を調べ、そのうち199,981行を除外して19行を返しています。除外された行が多い場合は、条件に合うインデックスを使えるか確認する手掛かりになります。
今回はloops=1ですが、同じノードが複数回実行される場合はactual timeと実測のrowsは1回あたりの平均です。そのノードの合計を考えるときはloopsも確認します。
Planning Timeは実行計画の作成にかかった時間、Execution Timeは実行段階にかかった時間です。計測処理の負荷が加わる一方、通常のSELECTのように結果行をクライアントへ送る時間は含まれないためアプリで計った応答時間とは一致しません。
今回のExecution Timeは10.292msでした。この値だけで遅いとは判断できませんが、19行を返すために20万行を調べています。次にインデックスを作成し、実行計画と時間の変化を確認します。
インデックスを張って比較する
customer_id列にインデックスを作ってから同じクエリを実行してみます。
CREATE INDEX idx_orders_customer_id ON orders (customer_id);EXPLAIN ANALYZE SELECT * FROM orders WHERE customer_id = 42;Bitmap Heap Scan on orders (cost=4.45..77.33 rows=20 width=22) (actual time=0.037..0.094 rows=19 loops=1)
Recheck Cond: (customer_id = 42)
Heap Blocks: exact=19
-> Bitmap Index Scan on idx_orders_customer_id (cost=0.00..4.45 rows=20 width=0) (actual time=0.025..0.025 rows=19 loops=1)
Index Cond: (customer_id = 42)
Planning Time: 0.307 ms
Execution Time: 0.125 msExecution Timeが10.292msから0.125msまで縮みました。今回の条件ではインデックスを使うBitmap Heap Scanに変わり、テーブル全体を調べずに対象行を取り出せています。
Bitmap Heap ScanはBitmap Index Scanで条件に合う行の位置をまとめ、その行があるページを順に読み取る方式です。ページごとにまとめて読むことで効率がよくなる場合がありますが、行の位置をまとめる処理も必要です。少数の行だけを取得する場合はIndex Scan、多くの行を取得する場合はSeq Scanが有利なこともありBitmap Heap Scanが常に速いわけではありません。
主キーのように絞り込みがさらに強い条件だと、この中間ステップを挟まないシンプルなIndex Scanが選ばれます。
EXPLAIN ANALYZE SELECT * FROM orders WHERE id = 12345;Index Scan using orders_pkey on orders (cost=0.42..8.44 rows=1 width=22) (actual time=0.018..0.018 rows=1 loops=1)
Index Cond: (id = 12345)
Planning Time: 0.292 ms
Execution Time: 0.049 msここに載せた実行時間は今回の検証結果です。データの分布、キャッシュの状態、サーバーの負荷などによって実行計画や時間は変わります。同じ改善幅が得られるとは限りません。
UPDATEで実験すると本当に更新される
実際にUPDATE文でEXPLAIN ANALYZEを試してみます。まず対象行の状態を確認します。
SELECT id, status FROM orders WHERE id = 1;id | status
----+--------
1 | newこの状態でEXPLAIN ANALYZEを実行します。
EXPLAIN ANALYZE UPDATE orders SET status = 'cancelled' WHERE id = 1;Update on orders (cost=0.42..8.44 rows=0 width=0) (actual time=0.078..0.078 rows=0 loops=1)
-> Index Scan using orders_pkey on orders (cost=0.42..8.44 rows=1 width=38) (actual time=0.011..0.012 rows=1 loops=1)
Index Cond: (id = 1)
Planning Time: 0.225 ms
Execution Time: 0.124 ms先頭のUpdateノードにrows=0と出ていますが更新件数が0という意味ではありません。このSQLにはRETURNINGがないためUpdateノードから上へ返す行が0になっています。更新されたかは続くSELECTでもう一度statusを確認してみます。
SELECT id, status FROM orders WHERE id = 1;id | status
----+-----------
1 | cancellednewからcancelledに変わっていました。オートコミットモードで実行した場合、この時点ですでにコミットも済んでいます。「実行計画を見ているだけ」のつもりでUPDATE文にEXPLAIN ANALYZEを付けるとそのままデータが書き換わってしまうということです。WHERE句の条件を書き間違えていた場合や対象が大量の行にまたがるUPDATE・DELETEだった場合は、被害範囲もそのまま大きくなっちゃいますね・・・。
BEGIN→EXPLAIN ANALYZE→ROLLBACKで変更を取り消す
更新系のSQLに対してEXPLAIN ANALYZEを使いたいけれどデータは変えたくない。そういうときのために公式ドキュメントもトランザクションで囲んでロールバックする方法を案内しています。先ほど更新してしまったstatusを元に戻してから試します。
UPDATE orders SET status = 'new' WHERE id = 1;BEGIN;
EXPLAIN ANALYZE UPDATE orders SET status = 'cancelled' WHERE id = 1;
ROLLBACK;BEGIN
Update on orders (cost=0.42..8.44 rows=0 width=0) (actual time=0.048..0.048 rows=0 loops=1)
-> Index Scan using orders_pkey on orders (cost=0.42..8.44 rows=1 width=38) (actual time=0.018..0.019 rows=1 loops=1)
Index Cond: (id = 1)
Planning Time: 0.273 ms
Execution Time: 0.094 ms
ROLLBACKROLLBACK後にstatusを確認すると、ちゃんとnewのままでした。
id | status
----+--------
1 | newこの例のUPDATEによる行の変更はコミット前にROLLBACKすることで取り消せます。実行計画と実測値は確認できるので、更新内容を確定させずに調査できます。
ROLLBACKですべての影響を元に戻せるわけではありません。たとえばnextvalで進んだシーケンスの値は戻りません。関数やトリガーが外部システムへ行った処理もROLLBACKでは取り消せない場合があります。
このトランザクションが開いている間は対象行のロックが取られたままになります。同じ行を更新しようとする他の処理があるとROLLBACKするまで待たされます。確認が終わったら間を置かずROLLBACKするのが基本です。
BUFFERSオプションとPostgreSQL 18からの変更点
EXPLAIN ANALYZEにBUFFERSオプションを付けると、共有バッファで見つかったブロック数や、共有バッファへ読み込んだブロック数などを確認できます。
EXPLAIN (ANALYZE, BUFFERS) SELECT * FROM orders WHERE customer_id = 42;Bitmap Heap Scan on orders (cost=4.45..77.33 rows=20 width=22) (actual time=0.018..0.065 rows=19 loops=1)
Recheck Cond: (customer_id = 42)
Heap Blocks: exact=19
Buffers: shared hit=21
-> Bitmap Index Scan on idx_orders_customer_id (cost=0.00..4.45 rows=20 width=0) (actual time=0.010..0.010 rows=19 loops=1)
Index Cond: (customer_id = 42)
Buffers: shared hit=2
Planning:
Buffers: shared hit=86
Planning Time: 0.234 ms
Execution Time: 0.093 msshared hitは必要なブロックがPostgreSQLの共有バッファ内にあった回数です。shared readは共有バッファになかったブロックを読み込んだ数を示します。OSのキャッシュから読み込む場合もあるのでshared readを物理ディスクへのアクセス回数とは断定できません。
上位ノードのBuffersには子ノードの分も含まれます。今回のshared hit=21にはBitmap Index Scanのshared hit=2が含まれているので、合計23とは数えません。
筆者の検証環境はPostgreSQL 16なので、上の例のようにBUFFERSオプションを手動で付ける必要がありました。PostgreSQL 18以降ではEXPLAIN ANALYZEを実行するだけでバッファ情報が自動的に表示されるようになっています。
PostgreSQL 18からはさらにインデックススキャンのノードにIndex Searchesという項目も追加されました。これはインデックスを何回探索したかを示す数値で、IN句に複数の値を指定したときのように1回のノード実行で複数回インデックスを探索するケース(スキップスキャンなどの新しい最適化が使われているかどうか)を見分けるのに役立ちます。この項目もEXPLAIN ANALYZEを使ったときだけ表示されます。
まずどこを見ればいいか
実行計画を見慣れていないと情報量の多さに圧倒されがちです。最初は次の4点だけ確認すれば十分です。
- 見積もりのrowsと実測のrowsが大きくズレていないか
- 条件や取得件数に合ったスキャン方式が選ばれているか
- Execution Timeがどのくらいか
- Rows Removed by Filterが大きすぎないか
このあたりに違和感があれば絞り込み条件やインデックス、統計情報を確認します。
本番環境でEXPLAIN ANALYZEを使うときの注意
EXPLAIN ANALYZEは対象のSQLを実際に実行します。重いSELECTにも負荷があり、UPDATE・DELETEでは対象行のロックも発生します。更新系SQLはまず書き込み可能な検証環境で確認してください。一般的な読み取り専用レプリカではUPDATE・DELETEのEXPLAIN ANALYZEは実行できません。
本番で更新系SQLを確認する必要がある場合は対象範囲と関数・トリガーの副作用を確認したうえで、同じ接続内でBEGINからROLLBACKまで実行します。ROLLBACKはすでに発生した負荷やロック待ちまで取り消すものではありません。
迷いやすいポイント
まとめ
- EXPLAINは計画を見るだけEXPLAIN ANALYZEは実際に実行して実測するんだよ。
- costの数字はミリ秒じゃなくてあくまで見積もりの相対値なんだよ。
- UPDATEやDELETEの変更を残したくないときはBEGIN→EXPLAIN ANALYZE→ROLLBACKで確認できるけれど、実行中の負荷やロック、シーケンスなどの影響には注意が必要だよ。
- PostgreSQL 18からはBUFFERSが自動表示されてIndex Searchesという項目も増えているよ。
- まずはrowsの見積もりと実測の差、Seq ScanかIndex Scanかを見るところから始めるとわかりやすいよ。
PostgreSQLの集計SQLや接続設定、Dockerでの環境構築も確認したい場合はデータベースまとめから探せます。